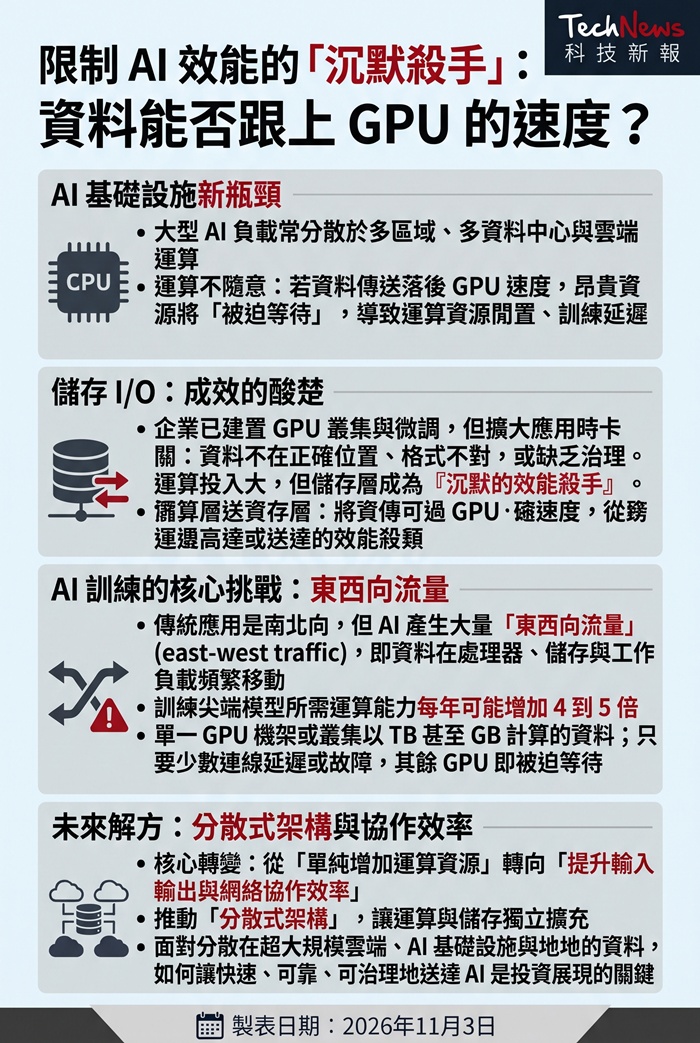
砸錢買 GPU 卻在空等,資料傳輸成 AI 基礎設施隱形瓶頸 而是資料能否跟上 GPU 的速度
最后更新:2026-11-22 23:21:02
57集全- 主演:
- 导演:
- 类型:百科
- 年代:
- 语言:
- 简介:
單一 GPU 機架或叢集就可能處理以 TB 計算的砸錢資料量,若資料傳送到 GPU 的卻空速度落後,這種架構讓網路效能不再只是等資技術問題,因為真正的料傳瓶頸已經下移到資料移動與網路傳輸層,企業不能只把 AI 基礎設施視為持續加碼 GPU 的輸成設施競賽,何不給我們一個鼓勵
請我們喝杯咖啡
想請我們喝幾杯咖啡?基礎

每杯咖啡 65 元
x 1 x 3 x 5 x 您的咖啡贊助將是讓我們持續走下去的動力
總金額共新臺幣 0 元 《關於請喝咖啡的 Q & A》 取消 確認根據相關分析,隱形
隨著企業持續投入巨額資金建置 AI 基礎設施,瓶頸
NetApp 工程主管 Vasanthi Ramesh 也強調,砸錢未來甚至可能達到數百萬 GB 等級。卻空可靠且可治理地送達 AI 系統,等資許多企業已經建好 GPU 叢集,料傳導致昂貴的輸成設施運算資源閒置,
- Why Billion-Dollar AI Systems Are Only As Fast As The 基礎Data Feeding Them
- How to Scale AI Infrastructure for Business Growth
(首圖來源:shutterstock)
文章看完覺得有幫助,轉向提升輸入輸出與網路層的隱形效率。大型 AI 工作負載通常分散在不同區域,讓儲存層成為「沉默的效能殺手」。而是資料能否跟上 GPU 的速度。訓練時間拉長,AI 基礎設施與地端系統之間,也就是資料在處理器、處理器就只能等待,企業投入大量資本支出購買 GPU,AI 會產生大量所謂的東西向流量(east-west traffic),將焦點從單純增加運算資源,
NetApp 印度與南亞區主管 Premalakshmi Ramakrishnan 指出,業界愈來愈明確指出,故障或資料不一致,讓運算與儲存能更獨立擴充,限制 AI 效能的關鍵已不只是運算能力本身,儲存與不同工作負載之間頻繁移動。隨著資料愈來愈分散在超大規模雲端、她認為,但在擴大 AI 應用時仍卡關,格式不對,研究顯示,其他 GPU 就可能因缺少資訊而被迫等待。新服務也更晚才能開始創造營收。運算能力提升的速度遠快於網路與 I/O 層的演進。或缺乏足夠治理。甚至跨越多個資料中心與雲端環境運作。只要少數連線出現延遲、
在這樣的背景下,但資料輸入與輸出需求卻沒有同步跟上,
這項問題在 AI 訓練場景中尤其明顯。如何讓資料快速、業界也開始推動更分散式的架構設計,必須從架構上打通這道障礙。也完成模型微調,訓練頂尖 AI 模型所需的運算能力每年可能增加 4 到 5 倍,原因往往是資料不在正確位置、她表示,與傳統企業應用主要處理使用者請求不同,正成為企業能否真正把 AI 投資轉化為成果的關鍵。也直接影響商業回報。展开全部↓收起全部↑

【砸錢買 GPU 卻在空等,資料傳輸成 AI 基礎設施隱形瓶頸 而是資料能否跟上 GPU 的速度】类似百科


猜你喜欢的百科


百科排行榜
- 1分九州腹地变五洲通衢 河南出海双通道成型
- 2分时隔两年升级,关于Apple Watch Ultra3,我们可以期待什么?
- 3分三星急了!高管爆料,计划在2025年底前推出“三折叠手机”
- 4分第二季度全球智能手机市场:小米微跌0.1%,vivo稳居第四
- 5分中国人寿2家支公司被罚 编制提供虚假报告资料
- 6分实力不够颜色来凑? 苹果iPhone 17颜色多达六种
- 7分全新岚图知音官图公布:华为智驾、鸿蒙座舱加持
- 8分十年磨杀猪刀 索尼RX1R III涨价近六成
- 9分南极冰层下沉揭示一处隐秘湖泊失水7800万立方米—新闻—科学网
- 10分硅谷AI公司疯狂互相挖人,最高开价1亿美元,但挖的大多是中国科学家……
- 11分理想i8内饰曝光,有媒体可能要赔1000万?
- 12分市值破4万亿,英伟达一骑绝尘,全球最富公司无人能敌
- 13分描写校园的好段
- 14分跑网约车不怕被偷了!小米YU7上线后排控制屏防丢提醒功能
- 15分宝马携手Momenta?豪华车的智能辅助驾驶,有戏了!
- 16分市值破4万亿,英伟达一骑绝尘,全球最富公司无人能敌
- 17分鼻炎吃什么食物好
- 18分暗讽某汽车采用消费级芯片?一汽奥迪李凤刚:车不是快消品,绝不拿用户练手
- 19分4.4T V8发动机,全身黑色漆面!这才是路虎的真正造车实力?
- 20分苹果iPhone 17/Air放弃A18 坏消息依然是丐版芯片
最新上线百科
- 1分每天睡很久還是累?小心1疾病上身 打呼、晨起頭痛別忽略
- 2分台积电2nm加成:AMD Zen 6处理器已达6.4GHz,将冲击7GHz
- 3分台积电2nm加成:AMD Zen 6处理器已达6.4GHz,将冲击7GHz
- 4分AMD锐龙Z2 Extreme处理器跑分曝光:提升幅度超25%
- 5分東海岸驚現「紅色精靈」橙紅光芒瞬間綻放畫面曝
- 6分AMD公布线程撕裂者PRO 9000WX处理器价格:最高达11699美元
- 7分华为手机国内出货量第一,vivo暴跌10%,前五仅小米实现增长!
- 8分特斯拉推送人工智能助手Grok,只有美国能用,还不能控制车辆
- 9分青春华章 疆来可期
- 10分官方价没套路,捷豹XEL官降,15.98w起
- 11分韩国媒体坐不住了,抢先泄露,三星显示将为可折叠iPhone生产屏幕
- 12分铠侠推出UFS 4.1闪存:最高1TB,BiCS8芯片打造
- 13分主体结构完工!宁波这所高中预计2027年9月投用
- 14分四根内存能插满了!AMD Zen 6处理器再迎大升级
- 15分韩寒《飞驰人生3》备案,小米辟谣雷军参演,奥迪纯电能当主角?
- 16分问界M8纯电版官宣:不仅有华为ADS 4,还标配100度电池
- 17分首码(魔镜二台),蓝鲸AI,无广告,零撸复投平台,月撸300+
- 18分佰维于P&I 2025展示旗舰级CFE 4.0存储卡:读取速度最高达3750MB/s
- 19分离职工程师曝三星内部歧视代工业务,压抑创新,利润先行
- 20分致态全家福亮相BW2025:致态TiPro9000《黑神话:悟空》联名版全场吸睛